
机器学习基础
概论
机器学习(Machine Learning)是人工智能的一个分支,它的核心思想是让计算机从数据中自动学习规律,而不是由人手工编写规则。
监督学习(Supervised Learning)
监督学习是指:训练数据中每个样本都带有"标准答案"(标签 label),模型通过学习输入特征 X 到输出 y 的映射关系,从而对新数据做出预测。
形式化地说:给定训练集
- 回归(Regression): 预测连续数值
- 分类(Classification):预测离散类别
无监督学习(Unsupervised Learning)
无监督学习是指:训练数据没有标签(没有"标准答案"),模型只能从数据本身的分布和结构中发现规律。
形式化地说:给定训练集
- 聚类(Clustering):把相似样本归为一组,组内相似、组间差异大。如用户分群、新闻聚合、图像分割。
- 降维(Dimensionality Reduction):把高维数据压缩到低维,保留主要信息。目的:去噪、加速计算、可视化、缓解"维度灾难"。
- 异常检测(Anomaly Detection):找出与大多数样本明显不同的"离群点"。如信用卡欺诈检测、设备故障预警。
- 关联规则挖掘(Association Rules):发现事物之间的共现关系。经典例子:"啤酒与尿布"购物篮分析。
回归(Regression)
一元线性回归 Linear Regression with One Variable
线性回归的模型表示为
:权重, 每增加 1 个单位, 平均变化 :偏置, 时的预测值 - (x
, y ):表示第 个训练样本
只有一个特征
代价函数 Cost Function
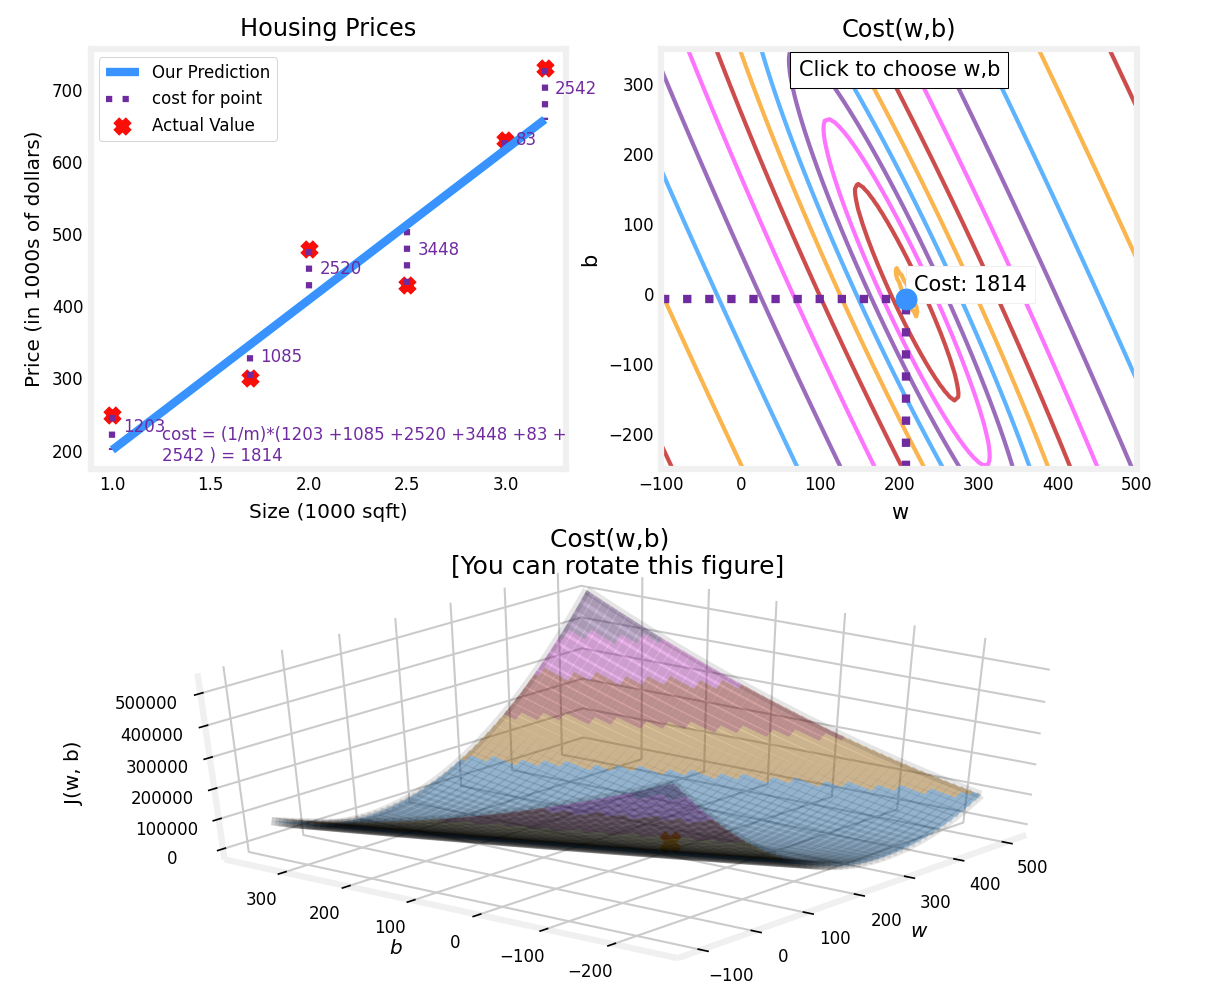
Cost Function是机器学习中用来衡量模型预测结果与真实结果之间差距的函数。用来评价模型的好坏
一元线性回归中我们选择的参数
使用平方误差代价函数(Squared Error Cost Function) 作为代价函数,公式为:
其中:
是我们使用参数 对第 个样本的预测值。 是目标值与预测值之间的平方差。 - 将所有
个样本的这些差值求和,再除以 2m,即得到代价。
NOTE
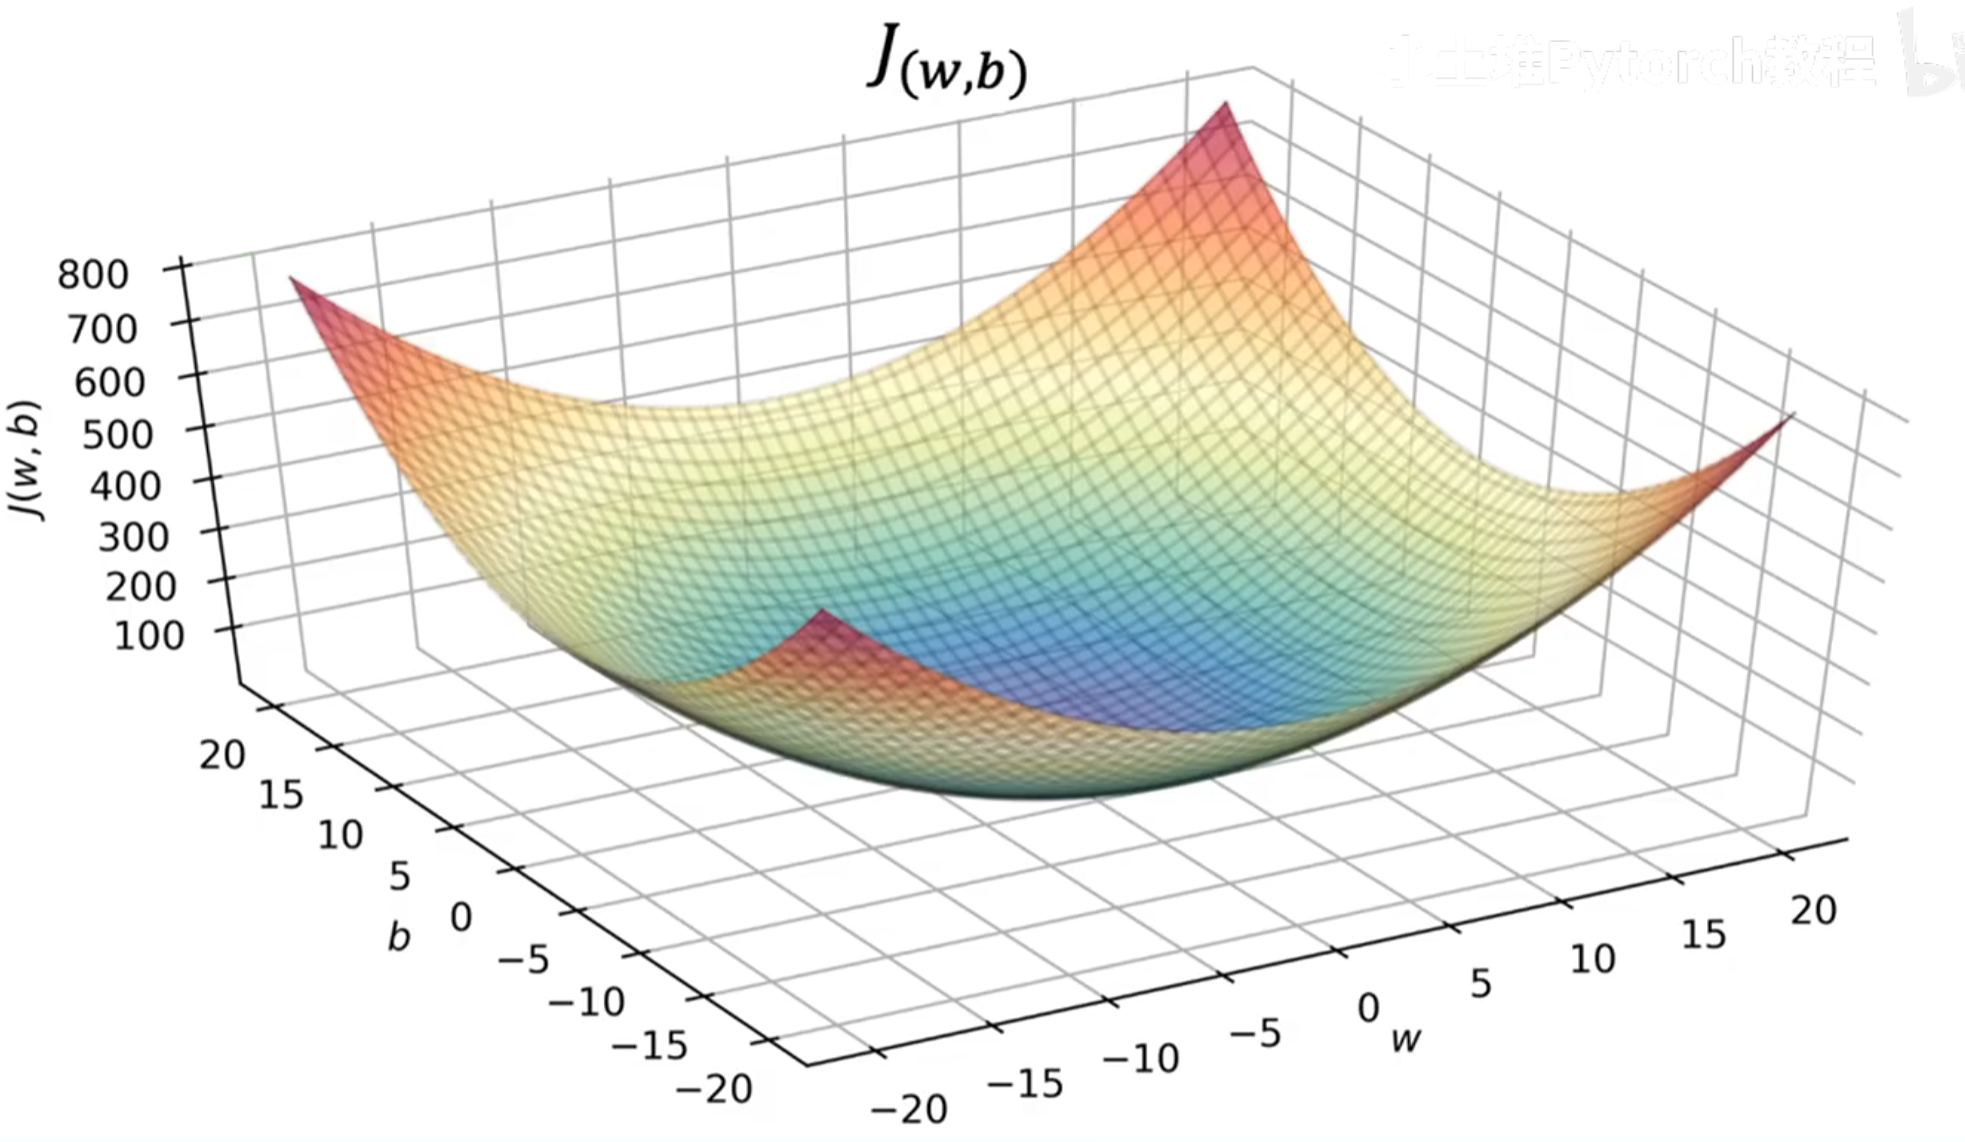
损失函数对损失值做平方处理这一特性,能保证 “误差曲面” 呈汤碗状的凸曲面。该曲面始终存在最小值,沿所有维度的梯度方向迭代都能找到这个最小值。
梯度下降 Gradient Descent
求解最小二乘法就是在线性回归中,它对应的就是让 Cost Function 最小。这个优化问题可以通过解析方法(正规方程)直接求解,也可以通过迭代优化方法(如梯度下降)求解。在机器学习实践中,当数据规模较大或模型复杂时,通常更倾向使用梯度下降
梯度下降背后的思想是:开始时我们随机选择一个参数的组合,计算代价函数,然后我们寻找下一个能让代价函数值下降最多的参数组合。我们持续这么做直到到到一个局部最小值(local minimum)。因为我们并没有尝试完所有的参数组合,所以不能确定我们得到的局部最小值是否便是全局最小值(global minimum),选择不同的初始参数组合,可能会找到不同的局部最小值。
代价函数:
批量梯度下降(batch gradient descent)算法的公式为:
梯度的定义为:
在梯度下降中,在计算微分求导项时,我们需要进行求和运算,所以,在每一个单独的梯度下降中,我们最终都要计算所有个训练样本求和。因此,批量梯度下降法这个名字说明了我们需要考虑所有这一"批"训练样本,而事实上,有时也有其他类型的梯度下降法,不是这种"批量"型的,不考虑整个的训练集,而是每次只关注训练集中的一些小的子集,称为小批量梯度下降(Mini-batch Gradient Descent)
一元回归代码实现
import numpy as np
import matplotlib.pyplot as plt

x = np.array([])
y = np.array([])

with open("./dataset/ex1data1.txt", "r", encoding="utf-8") as f:
    for line in f.readlines():
        data = line.strip().split(',')
        x = np.append(x, float(data[0]))
        y = np.append(y, float(data[1]))

m = len(x)
# print(np.hstack([np.ones((m, 1)), x.reshape(-1, 1)]))
X = np.c_[np.ones(m), x]

n = 5000
a = 0.01
# [b, w]
W = np.zeros((2, 1))
# print(W)
for _ in range(n):
    y_pred = X @ W
    # print(X.shape)
    # print(W.shape)
    grad = X.T @ (y_pred - y.reshape(-1, 1))
    W = W - (grad / m) * a

print(W)
plt.scatter(x, y)
x_plot = np.array([np.min(x), np.max(x)])
y_plot = W[0] + x_plot * W[1]
plt.plot(x_plot, y_plot, c="m")
plt.show()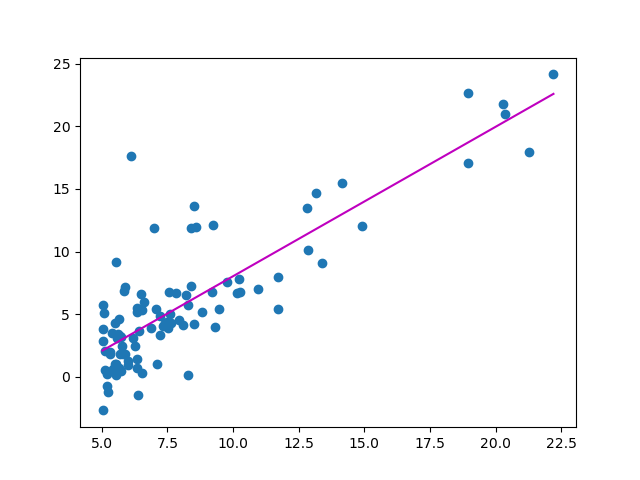
多元线性回归 Multiple Linear Regression
模型表示为:
向量表示为 dot product
代价函数
梯度下降算法
特征数量为n, 参数
特征缩放与标准化
当不同自变量取值范围相差较大时,绘制的等高线图上的椭圆会变得瘦长,而梯度下降算法收敛将会很慢,因为每一步都可能会跨过这个椭圆导致振荡。此时,我们需要把所有自变量进行缩放、标准化,使其落在 -1 到 1 之间。
NOTE
标准化改变数据分布,让均值为 0、标准差为 1;归一化改变数据范围,把数据压缩到固定区间。
在机器学习中,标准化是更常用的手段,归一化的应用场景是有限的。因为「仅由极值决定」这个做法过于危险,如果样本中有一个异常大的值,则会将所有正常值挤占到很小的区间,而标准化方法则更加「弹性」,会兼顾所有样本
- 特征缩放(Feature scaling):
- 简单版:将每个正特征除以其最大值 ,结果 [0, 1]
- 通用版:
(x - min) / (max - min),适用于任意特征,结果 [0, 1] - 两种方式都将特征归一化到 -1 到 1 范围内。
- 均值归一化(Mean normalization):
,结果约 [-0.5, 0.5],数据居中 - Z-score 标准化(Z-score normalization):
,$$j$$ 为某个特征,结果均值 0、方差 1,最常用,其中
其中
是第 个特征的均值, 是标准差。
WARNING
此外,线性回归并不适用于所有情形,有时我们需要曲线来适应我们的数据,这时候我们也要对特征进行构造,如二次函数、三次函数、幂函数、对数函数等。构造后的新变量就可以当作一个新的特征来使用,这就是多项式回归(Polynomial Regression)。新变量的取值范围可能更大,此时,特征缩放就非常有必要!
多元回归代码实现
import numpy as np
import matplotlib.pyplot as plt

x = []
y = []

with open("./dataset/ex1data2.txt", "r", encoding="utf-8") as f:
    for line in f.readlines():
        data = list(map(float, line.strip().split(',')))
        x.append(data[:-1])
        y.append(data[-1])

x = np.array(x)
y = np.array(y)
# print(x.shape, y.shape)

# 标准化
u = np.mean(x, axis=0)
sigma = np.std(x, axis=0)
x = (x - u) / sigma
# print(x)

m, n = x.shape
X = np.c_[np.ones(m), x]
W = np.zeros((n + 1, 1))

niter = 1500
a = 0.01
J_history = []
for i in range(niter):
    y_pred = X @ W
    error = y_pred - y.reshape(-1, 1)
    grad = X.T @ error
    W = W - a * (grad / m)
    J_history.append(np.sum(error ** 2) / (2 * m))

print(W)
# 面积,房间数
input_data = np.array([1650, 3])
input_data = (input_data - u) / sigma
pred = np.r_[np.ones(1), input_data] @ W
print(pred.sum())


# plot the convergence graph
plt.plot(np.arange(len(J_history)), J_history)
plt.xlabel('Number of iterations')
plt.ylabel('Cost J')
plt.show()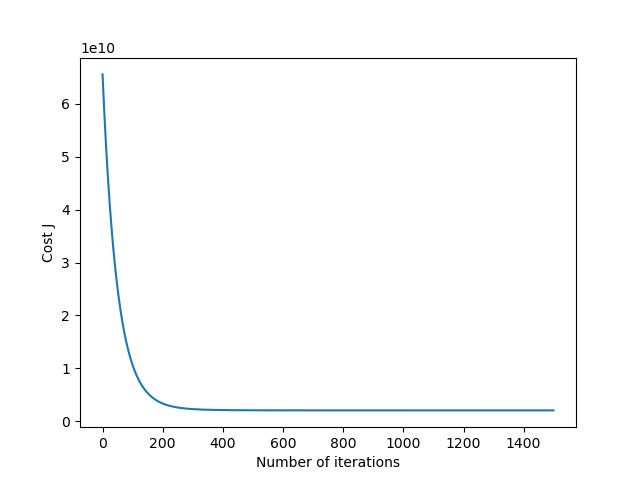
分类(Classification)
在分类问题中,我们尝试预测的结果是否属于某一个类,最基础的就是二元的分类问题,更为复杂的则是预测多元的分类问题。
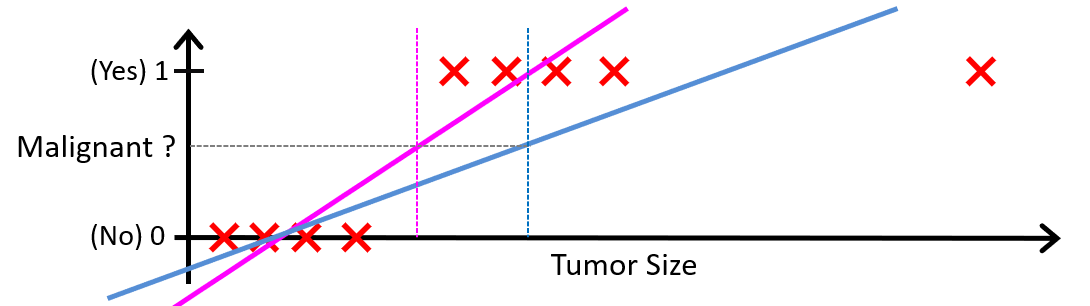
如果用线性回归来解决,即用一条直线拟合结果,当预测值大于阈值时归为正向类,反之归为负向类。然而,当阈值确定时,「反常样本」用于拟合直线时会对其决策边界造成一定偏移,以至于正常样本被归为错误类别。
逻辑回归 Logistic Regression
模型
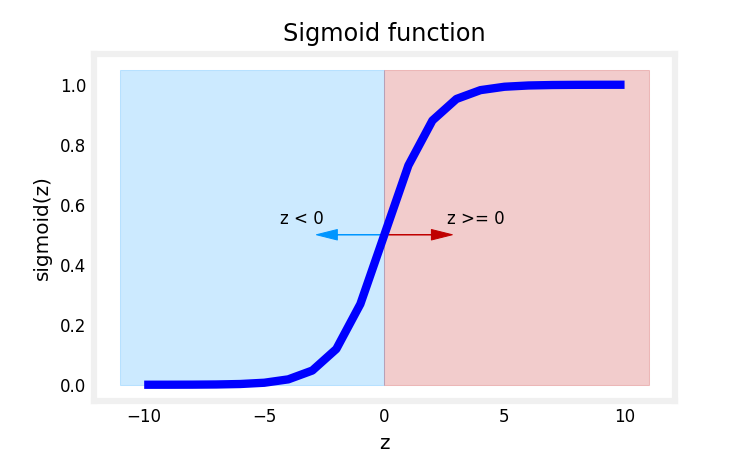
线性回归和逻辑回归都属于广义线性模型(Generalized Linear Model)的特殊形式。但由于逻辑函数(Losistic Function,也叫 Sigmoid 函数)将结果映射到 Bernoulli 分布,因此逻辑回归更常用于分类问题。
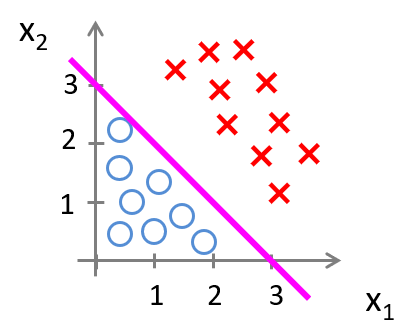
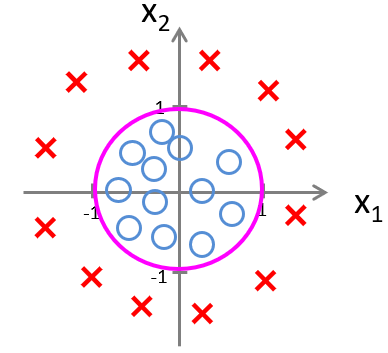
模型表示为:
if
if
代价函数
从训练集中拟合逻辑回归的参数
IMPORTANT
本文定义:损失用于衡量单个样本与其目标值之间的差异,而代价则是训练集上所有损失的综合度量
在线性回归中我们使用平方误差函数作为损失函数,如果继续使用会造成损失曲面非凸(坑坑洼洼很多局部最优),梯度下降会卡住。
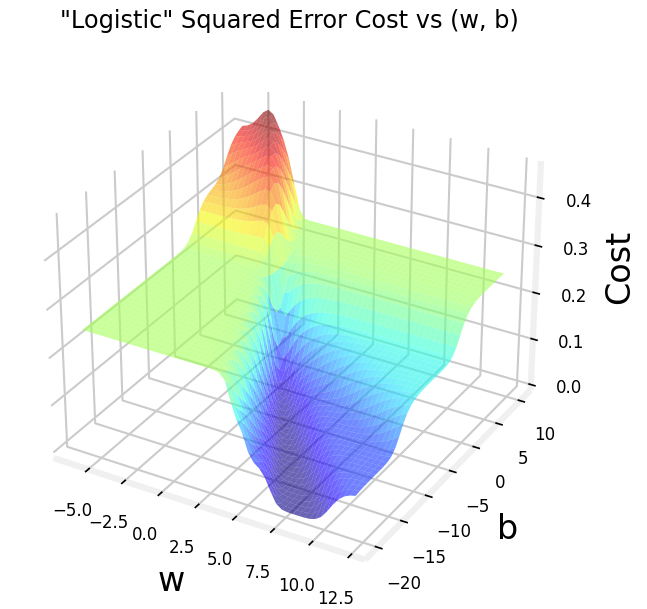
广义上定义的代价函数如下
在逻辑回归中,我们使用二元交叉熵作为代价函数,而交叉熵与 Sigmoid复合后,始终保持凸性
为模型预测, 为第 个标签 where function is the sigmoid function.
写成一个式子后如下
其中
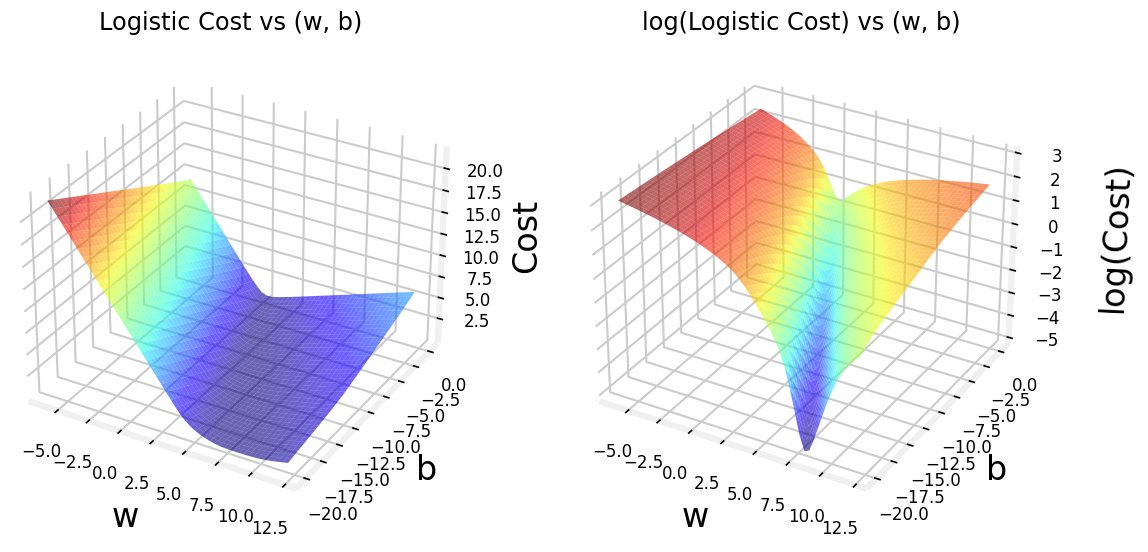
梯度下降
对代价函数求偏导后和线性回归的偏导形式完全相同,但
代码实现
import numpy as np
import matplotlib.pyplot as plt

data = np.loadtxt("./dataset/ex2data1.txt", delimiter=",")

# print(type(data))
x = data[:,0:-1]
y = data[:,-1].reshape(-1, 1)
m, n = x.shape

x = (x - x.mean(axis=0)) / x.std(axis=0)
X = np.c_[np.ones(m), x]


a = 0.01
niter = 10000
W = np.zeros((n + 1, 1))
J_history = []

for _ in range(niter):
    z = X @ W
    y_pred = 1 / (1 + np.exp(-z))
    grad = X.T @ (y_pred - y)
    W = W - a * (grad / m)

    cost = -np.mean(y * np.log(y_pred) + (1 - y) * np.log(1 - y_pred))
    J_history.append(cost)


print(W)

fig, (p1, p2) = plt.subplots(1, 2,figsize=(12, 5))
neg_pos = np.where(y == 0)[0]
pos_neg = np.where(y == 1)[0]
p1.scatter(x[neg_pos, 0], x[neg_pos, 1], c='red')
p1.scatter(x[pos_neg, 0], x[pos_neg, 1], c='blue')
p1.set_xlabel('feature 1 - norm')
p1.set_ylabel('feature 2 - norm')
x_plot = np.linspace(x[:, 0].min(), x[:, 0].max(), 100)
p1.plot(x_plot, (-W[1] * x_plot - W[0]) / W[2])

p2 = plt.subplot(1, 2, 2)
p2.plot(np.arange(len(J_history)), J_history)
p2.set_xlabel('Number of iterations')
p2.set_ylabel('Cost J')
plt.show()
决策边界和收敛结果如图
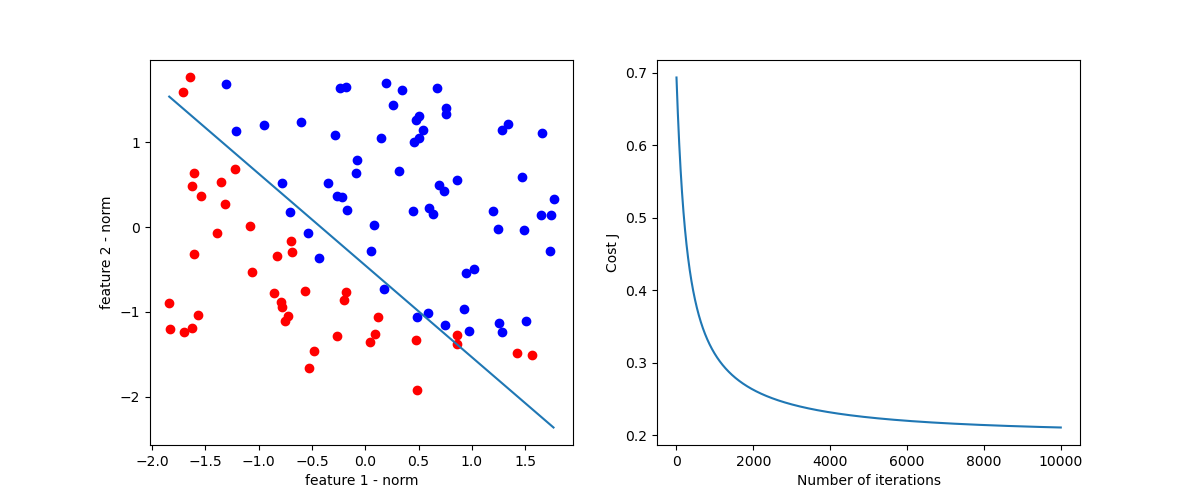
欠拟合和过拟合
欠拟合(Underfitting) 就是模型过于简单,没有充分学习训练数据中的规律。
过拟合(Overfitting) 就是模型把训练数据学得“太细”了,甚至把数据中的噪声和偶然性也当成了规律。
可以从以下几个方面解决过拟合
- 从模型层面,可以通过 Early Stop、L1/L2 Regularization、Batchnorm、Dropout 等方法;
- 从特征层面,可以丢弃一些不能帮助我们正确预测的特征,通过手工筛选或 PCA 等降维方法;
- 从数据层面,可以获取更大的数据集,也可以进行数据增强(Data Augmentation),通过一定规则来扩充数据。
正则化(Regularization)
正则化是一种能够保留所有特征(不必降维而丢失信息)的有效解决过拟合的方法。其思想是在损失函数上加上某些规则(限制),限制参数的解空间,从而减少求出过拟合参数的可能性。
以线性回归为例,在代价函数后加入正则项
NOTE
根据正则项的形式,又可分为:二次正则项、一般正则项。二次正则项即为前文提到的形式,更一般的形式为
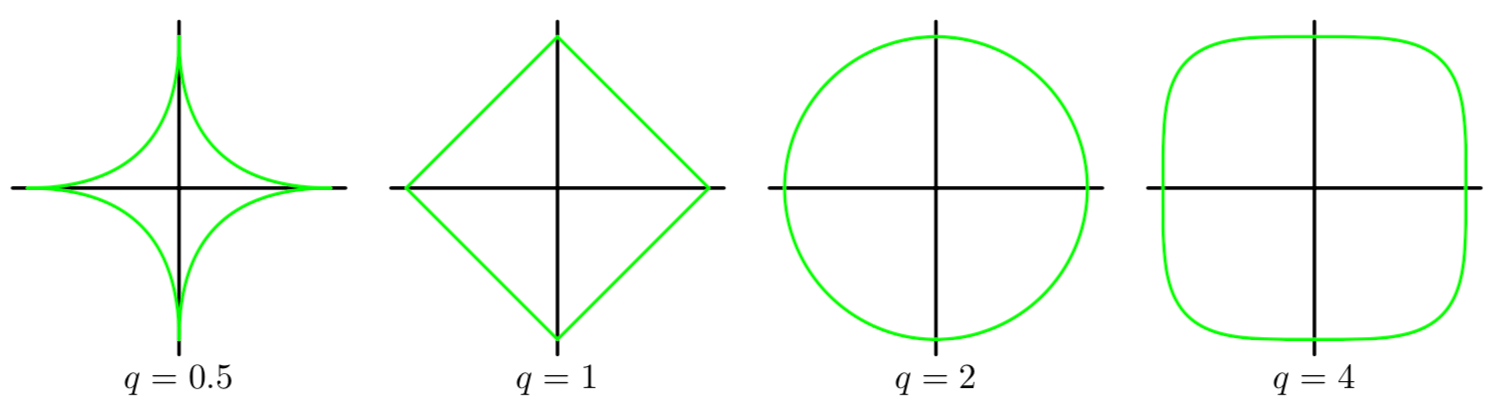
从几何空间上来看,损失函数的碗状曲面和正则化项的曲面叠加之后,就是我们要求极值的曲面。特别地,当
线性回归的正则化
含有正则化的代价函数为
梯度(求导后)
逻辑回归的正则化
含有正则化的代价函数为
梯度表达形式同线性回归
代码
import numpy as np
import matplotlib.pyplot as plt

data = np.genfromtxt("./dataset/ex2data2.txt", delimiter=',')
x = data[:,:-1]
x1 = data[:, 0]
x2 = data[:, 1]
y = data[:,-1].reshape(-1,1)

neg_pos = np.where(y == 0)[0]
pos_pos = np.where(y == 1)[0]
plt.scatter(x[neg_pos,0], x[neg_pos,1], c='red', marker='o')
plt.scatter(x[pos_pos,0], x[pos_pos,1], c='blue', marker='x')


m, n = x.shape
def map_feature(x1, x2):
    X = np.ones((len(x1),1))
    for i in range(1, 6 + 1):
        for j in range(0, i + 1):
            X = np.c_[X, (x1 ** j) * (x2 ** (i - j))]
    return X

X = map_feature(x1, x2) # (118, 28)
W = np.zeros((28, 1))
a = 0.01
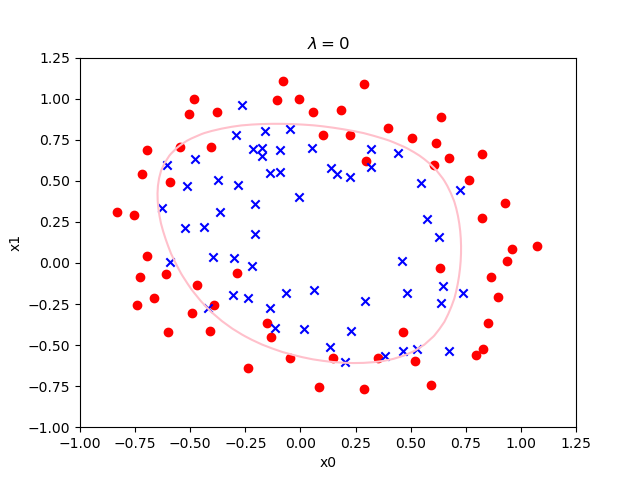
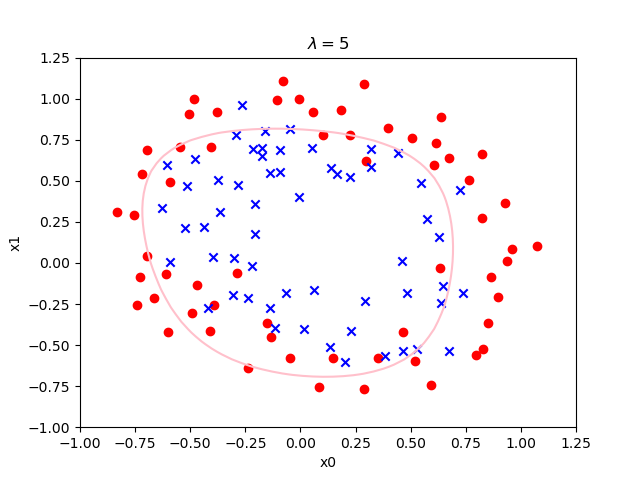
lamda = 5
niter = 10000

for _ in range(niter):
    Z = X @ W
    y_pred = 1 / (1 + np.exp(-Z))
    grad = X.T @ (y_pred - y) / m
    regular = (lamda / m) * np.r_[np.zeros((1,1)), W[1:, :]]
    W = W - a * (grad + regular)

print(W)
f1 = np.linspace(-1, 1.25, 50)
f2 = np.linspace(-1, 1.25, 50)
xv,yv = np.meshgrid(f1, f2)
Z = map_feature(xv.flatten(), yv.flatten()) @ W
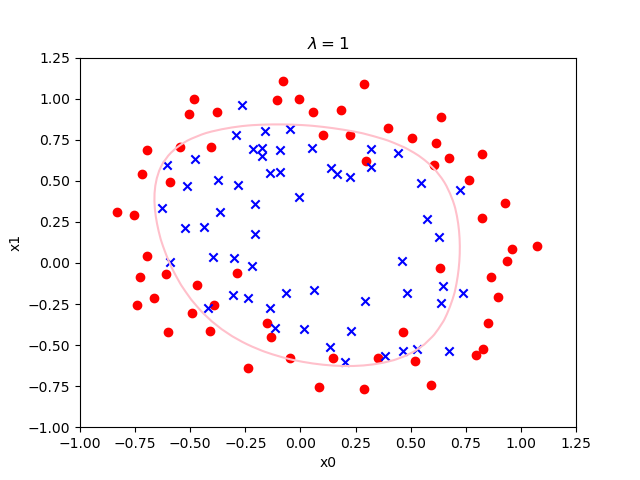
plt.contour(xv,yv,Z.reshape(50, 50), levels=[0], colors='pink')
plt.title(f"$\lambda = {lamda}$")
plt.xlabel("x0")
plt.ylabel("x1")
plt.show()
增大正则化参数
深度学习(Deep Learning)
神经元
神经网络的灵感来自大脑神经元:接收多个输入信号,加权整合,超过阈值就"激活"输出。数学上一个人工神经元就是:
:权重(连接强度), :偏置(激活难易程度) :激活函数(非线性变换) - 一个神经元 + sigmoid 激活 = 逻辑回归。神经网络本质上就是把成千上万个"逻辑回归单元"层层堆叠、首尾相连。
如果没有激活函数(或用线性激活),无论堆多少层,整体都等价于一个单层线性模型(矩阵连乘仍是矩阵)。非线性激活是神经网络能拟合复杂函数的根本原因。
| 激活函数 | 公式 | 导数 | 特点 |
|---|---|---|---|
| ReLU | 隐藏层默认选择;缺点: | ||
| Leaky ReLU | 给负区间一个小斜率(如 0.01),解决死亡 ReLU | ||
| Sigmoid | 输出 (0,1) 可作概率;两端梯度≈0 导致梯度消失;现主要用于输出层(二分类) | ||
| Softmax | — | 多分类输出层专用,输出概率分布 |
神经网络与前向传播
- 单层感知机:单个神经元模型(只有输入层 + 输出层,无隐藏层,激活函数为跃迁函数,无法解决XOR线性不可分)
- 多层感知机(MLP):感知机叠加隐藏层 + 非线性激活 + 反向传播训练,即"经典的前馈全连接神经网络"
- 神经网络:一般由输入层、隐藏层、输出层构成——MLP 是最基础的一种,还有 CNN、RNN、Transformer 等变体
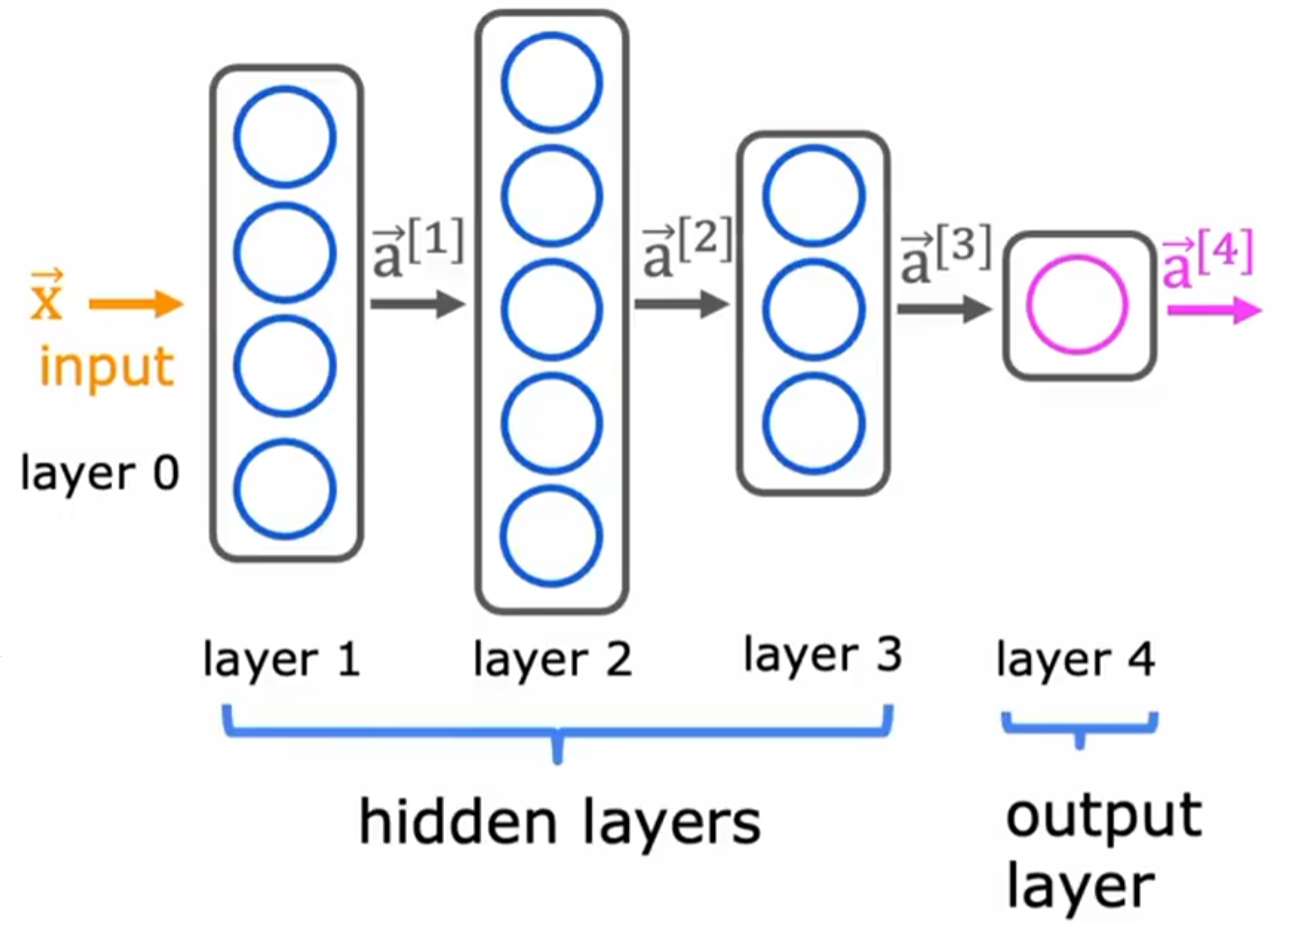
- 输入层:接收特征,不算"层数"
- 隐藏层:自动学习数据的中间特征表示(深度学习的"深度"就指隐藏层多)
- 输出层:按任务设计
NOTE
理论上:一个隐藏层 + 足够多的神经元 + 非线性激活,可以逼近任意连续函数。但"能逼近"不等于"容易训练",实践中用更深的网络换取参数效率。
以一个隐藏层的网络为例,前向传播(矩阵形式,
import matplotlib.pyplot as plt
import numpy as np
def load_coffee_data():
    """ Creates a coffee roasting data set.
        roasting duration: 12-15 minutes is best
        temperature range: 175-260C is best
    """
    rng = np.random.default_rng(2)
    X = rng.random(400).reshape(-1, 2)
    X[:, 1] = X[:, 1] * 4 + 11.5  # 12-15 min is best
    X[:, 0] = X[:, 0] * (285 - 150) + 150  # 350-500 F (175-260 C) is best
    Y = np.zeros(len(X))

    i = 0
    for t, d in X:
        y = -3 / (260 - 175) * t + 21
        if (t > 175 and t < 260 and d > 12 and d < 15 and d <= y):
            Y[i] = 1
        else:
            Y[i] = 0
        i += 1

    return (X, Y.reshape(-1, 1))

X, Y = load_coffee_data()
u = X.mean(axis=0)
sigma = X.std(axis=0)
X = (X - u) / sigma
print(f"Temperature Max, Min post normalization: {np.max(X[:,0]):0.2f}, {np.min(X[:,0]):0.2f}")
print(f"Duration    Max, Min post normalization: {np.max(X[:,1]):0.2f}, {np.min(X[:,1]):0.2f}")
print(X.shape, Y.shape)

neg_pos = np.where(Y == 0)
pos_pos = np.where(Y == 1)
plt.scatter(X[neg_pos, 0], X[neg_pos, 1], marker='x', c='r')
plt.scatter(X[pos_pos, 0], X[pos_pos, 1], marker='o', c='b')

def sigmoid(x):
    return 1 / (1 + np.exp(-x))

def my_dense(a_in, W, b):
    return sigmoid(a_in @ W + b)

def forward_prop(X):
    W1_tmp = np.array([[-8.93, 0.29, 12.9], [-0.1, -7.32, 10.81]])
    b1_tmp = np.array([-9.82, -9.28, 0.96])
    W2_tmp = np.array([[-31.18], [-27.59], [-32.56]])
    b2_tmp = np.array([15.41])
    A1 = my_dense(X, W1_tmp, b1_tmp)
    A2 = my_dense(A1, W2_tmp, b2_tmp)
    return A2

X_tst = np.array([
    [200,13.9],  # postive example
    [200,17]])   # negative example
X_tst = (X_tst - u) / sigma
predictions = forward_prop(X_tst)
print(predictions)
yhat = (predictions > 0.5).astype(int)
print(yhat)
plt.show()
反向传播 Back propagation
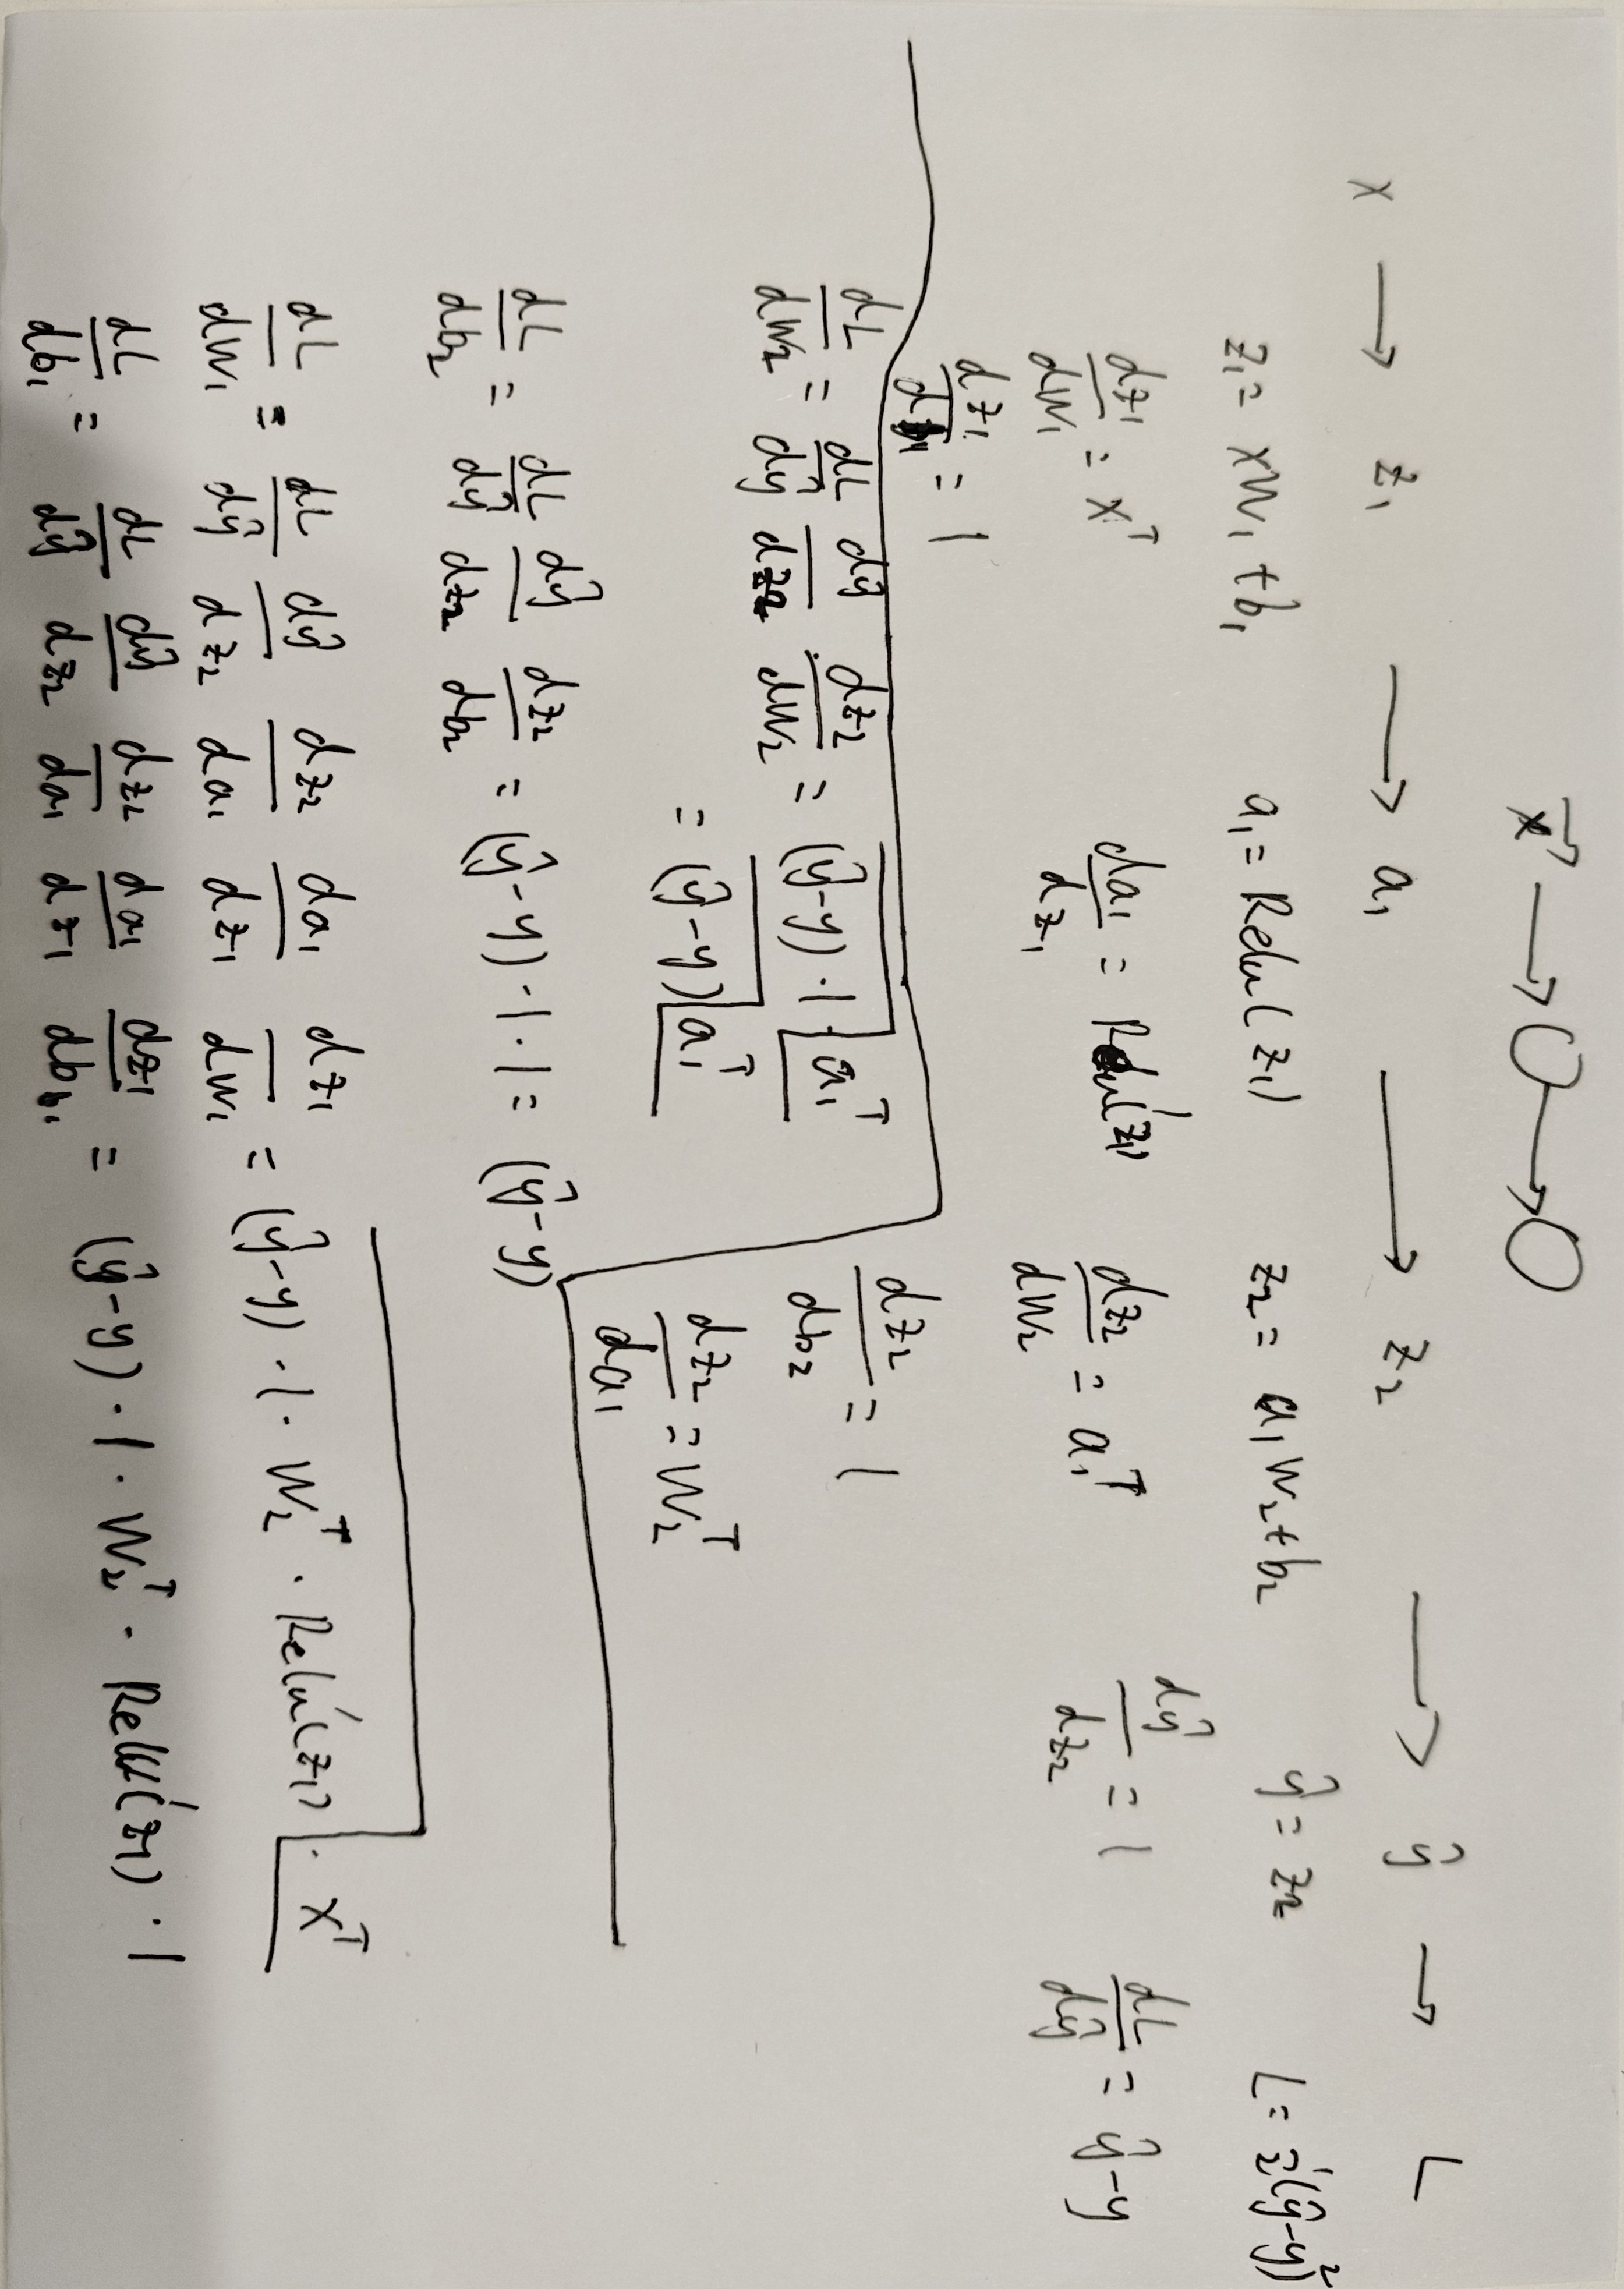
前向传播算出预测和损失;反向传播用链式法则从输出层往回,逐层算出每个参数对损失的梯度,然后用梯度下降更新。
前向传播(forward) → 计算损失(loss) → 反向传播(backward) → 参数更新(update)链式法则:
- 两层网络的标准反向传播公式(交叉熵 + softmax/sigmoid)
定义每层的误差项
规律:本层误差 = 后层误差"穿过"权重传回来 × 本层激活的导数;参数梯度 = 本层误差 × 本层输入。
代码实现
import matplotlib.pyplot as plt
import numpy as np


def load_coffee_data():
    pass # 同前向传播

X, Y = load_coffee_data()
u = X.mean(axis=0)
sigma = X.std(axis=0)
X = (X - u) / sigma
print(f"Temperature Max, Min post normalization: {np.max(X[:,0]):0.2f}, {np.min(X[:,0]):0.2f}")
print(f"Duration    Max, Min post normalization: {np.max(X[:,1]):0.2f}, {np.min(X[:,1]):0.2f}")
print(X.shape, Y.shape)

m, n = X.shape
J_history = []
# INPUT(m, 2) --> Hidden layer(3个神经元,ReLU) --> Output layer(1个神经元,Sigmoid+二元交叉熵)

W1 = np.array([[-8.93, 0.29, 12.9], [-0.1, -7.32, 10.81]])
b1 = np.array([-9.82, -9.28, 0.96])
W2 = np.array([[-31.18], [-27.59], [-32.56]])
b2 = np.array([15.41])

# --- 随机初始化,从头训练 ---
# np.random.seed(0)  # 固定随机种子,保证每次运行结果可复现
# W1 = np.random.randn(2, 3) * np.sqrt(2 / 2)  # He 初始化:ReLU 激活推荐 √(2/n_in)
# b1 = np.zeros(3)
# W2 = np.random.randn(3, 1) * np.sqrt(2 / 3)
# b2 = np.zeros(1)

def sigmoid(x):
    x = np.clip(x, -500, 500)
    return 1 / (1 + np.exp(-x))

def ReLU(x):
    return np.maximum(0, x)


def back_prop(X, Y, W1, b1, W2, b2, lr):
    # forward prop
    # (m,2) (2, 3)
    Z1 = X @ W1 + b1
    A1 = ReLU(Z1)
    # (m, 3) (3, 1)
    Z2 = A1 @ W2 + b2
    y_hat = sigmoid(Z2)

    y_hat = np.clip(y_hat, 1e-9, 1-1e-9)
    cost = -np.sum(Y * np.log(y_hat) + (1 - Y) * np.log(1 - y_hat)) / m
    J_history.append(cost)

    # back prop
    # (m, 1)
    dZ2 = y_hat - Y

    dW2 = (A1.T @ dZ2) / m
    db2 = np.mean(dZ2, axis=0)
    # db2_test = np.mean(dZ2, axis=0, keepdims=True)
    # print(b2, db2, db2_test)

    dZ1 = (dZ2 @ W2.T) * (Z1 > 0)
    dW1 = (X.T @ dZ1) / m
    db1 = np.mean(dZ1, axis=0)
    # print(b1, db1)

    W1 = W1 - lr * dW1
    b1 = b1 - lr * db1
    W2 = W2 - lr * dW2
    b2 = b2 - lr * db2
    return W1, b1, W2, b2

lr = 0.01
epochs = 1000

for _ in range(epochs):
    W1, b1, W2, b2 = back_prop(X, Y, W1, b1, W2, b2, lr)

plt.plot(J_history)
plt.xlabel("Epoch")
plt.ylabel("Cost")
plt.show()
训练常见问题
参数初始化
- 参数初始化0或相同值时所有神经元会永远学出相同特征(对称性无法打破)
- 常用:Xavier 初始化(适合 tanh)、He 初始化(适合 ReLU),按层宽缩放方差
梯度消失 / 梯度爆炸
- 反向传播连乘很多小导数 → 浅层梯度趋近 0,梯度消失**
- 对策:ReLU 激活、Batch Normalization、残差连接(ResNet)、合理初始化、梯度裁剪
过拟合
- Dropout:训练时随机"关掉"一部分神经元,强迫网络不依赖单个神经元
- L2 正则(weight decay)、早停(early stopping)、数据增强
优化器
SGD(Stochastic Gradient Descent,随机梯度下降)→ Momentum(动量加速)→ Adam(自适应学习率)